SecOps : relier sécurité et opérations IT pour passer de l’alerte à l’action
SecOps, contraction de Security Operations, désigne une démarche qui réunit les équipes de cybersécurité et d’exploitation informatique pour protéger les systèmes au quotidien. Son objectif : détecter les menaces, comprendre leur portée et coordonner une réponse sans perdre de temps entre services. Elle associe des personnes, des processus et des outils, dans les environnements locaux comme dans le cloud.
SecOps organise la sécurité autour du fonctionnement réel de l’entreprise
Une alerte de sécurité ne suffit pas à protéger une organisation. Encore faut-il savoir quel service est touché, qui peut intervenir et quelles conséquences aurait l’arrêt d’un équipement. SecOps relie la connaissance des menaces à la maîtrise opérationnelle du système d’information. La sécurité apporte l’analyse du risque ; les équipes IT connaissent les dépendances techniques, les utilisateurs et les contraintes de disponibilité.
Testez vos connaissances sur SecOps
Répondez aux six questions, puis validez vos réponses pour découvrir votre score.
Cette collaboration vise à réduire les angles morts, à limiter la propagation des attaques et à préserver la continuité d’activité. Elle concerne les terminaux, réseaux, identités, applications, données et infrastructures cloud, y compris dans les environnements hybrides ou multicloud.
SecOps et SOC ne désignent pas la même chose
Le SOC, ou Security Operations Center, est le centre chargé de surveiller, analyser et traiter les événements de sécurité. Il peut être interne, externalisé ou organisé selon un modèle hybride. SecOps désigne une démarche plus large : le SOC peut en constituer le noyau opérationnel, mais il travaille avec l’exploitation, les responsables applicatifs et la gouvernance.
Par rapport à une organisation cloisonnée, où la sécurité transmet ses recommandations à l’IT sans suivi commun, SecOps instaure des responsabilités et des procédures partagées. Il ne remplace pas les autres dimensions de la cybersécurité, comme la gestion des risques ou la sensibilisation : il rend la protection opérationnelle plus cohérente.
De la connexion suspecte à la reprise : le cycle d’un incident
Prenons un exemple : un compte utilisateur présente une connexion inhabituelle, puis tente d’accéder à des ressources sensibles. Ce signal peut correspondre à un déplacement légitime comme à un vol d’identifiants. L’équipe SecOps doit réunir suffisamment de contexte pour décider, sans banaliser le risque ni bloquer inutilement l’activité.
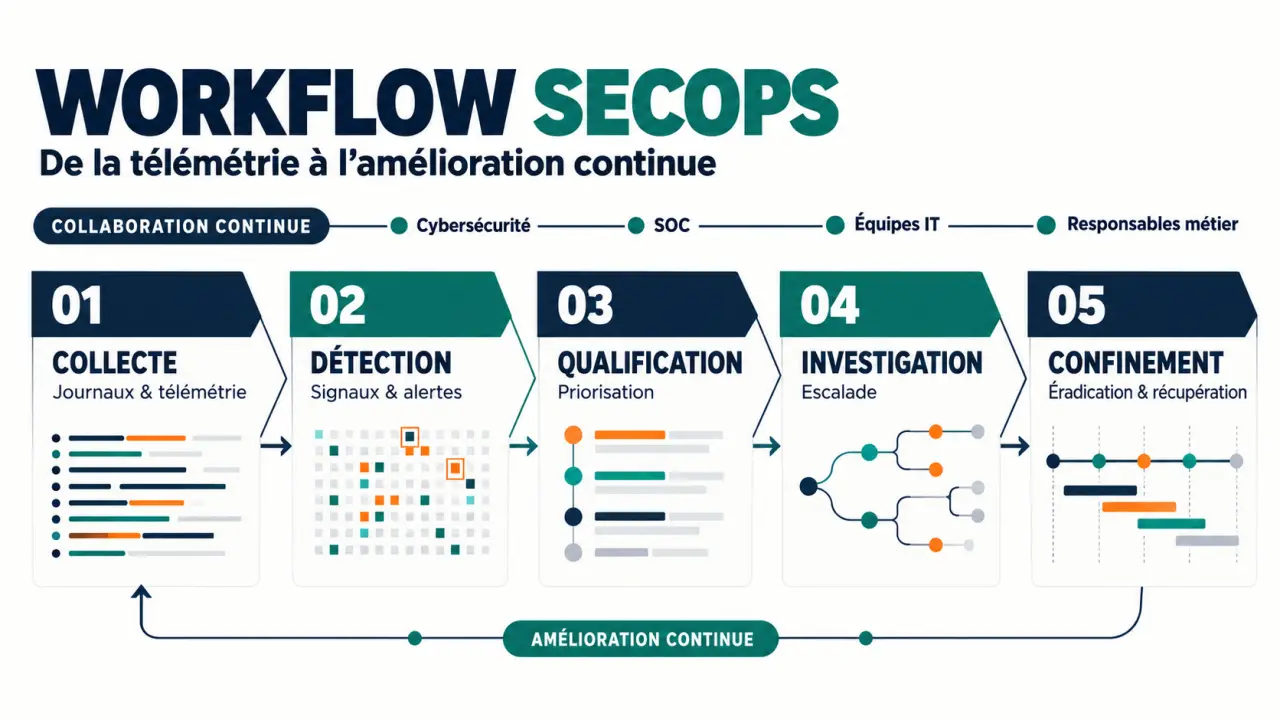
- Collecter et détecter : exploiter les journaux d’authentification, les événements réseau et la télémétrie des terminaux pour repérer les comportements suspects.
- Qualifier et prioriser : vérifier l’alerte, écarter les faux positifs et apprécier la criticité du compte et des ressources concernées.
- Investiguer et escalader : reconstituer la chronologie, rechercher d’autres systèmes touchés et mobiliser les interlocuteurs compétents.
- Contenir et éradiquer : révoquer des sessions, isoler un terminal ou supprimer un mécanisme de persistance selon l’incident confirmé.
- Récupérer et améliorer : restaurer un fonctionnement sûr, renforcer la surveillance et corriger les faiblesses révélées.
Ces étapes s’appuient sur des playbooks, des procédures qui précisent les vérifications, les actions autorisées et les conditions d’escalade. Une opération susceptible d’interrompre un service critique doit intégrer une validation adaptée et une possibilité de retour arrière.
Un dispositif SecOps fonctionne comme un pont dont il faut connaître la capacité de charge : une mesure de confinement protège une rive, mais peut couper l’accès à l’autre. Avant d’isoler un serveur, relier l’actif technique aux processus métier permet d’anticiper les effets en chaîne. Cette cartographie des dépendances transforme une décision purement technique en arbitrage éclairé entre risque de propagation et interruption de service.
En dehors des incidents déclarés, la chasse aux menaces recherche des traces d’attaque qui n’ont pas déclenché d’alerte. Le renseignement sur les menaces aide à formuler ces recherches et à ajuster les détections aux techniques des attaquants.
SIEM, SOAR, XDR : choisir les outils selon le travail attendu
Un programme SecOps n’est pas un empilement de logiciels. Chaque solution doit répondre à un besoin identifié : obtenir des traces exploitables, rapprocher des signaux dispersés ou exécuter une réponse coordonnée. Les fonctions peuvent se recouvrir selon les produits ; leur intégration compte autant que leur richesse fonctionnelle.
Guide NIST pour gérer et répondre aux incidents de cybersécurité — Ce guide officiel présente les bonnes pratiques pour analyser les incidents, les contenir et organiser une réponse efficace.
| Outil | Rôle principal | Point de vigilance |
|---|---|---|
| SIEM | Centraliser, analyser et corréler les journaux de sécurité. | Qualité des données collectées et pertinence des règles de détection. |
| SOAR | Orchestrer les procédures et automatiser des tâches de réponse. | Droits d’action, validations humaines et gestion des erreurs. |
| EDR | Détecter, investiguer et répondre sur les terminaux. | Couverture effective du parc et configuration des agents. |
| XDR | Rapprocher les signaux de plusieurs domaines : terminaux, identités, e-mails ou cloud. | Périmètre réellement couvert et compatibilité avec l’existant. |
| Sécurité cloud | Surveiller les configurations, accès et charges de travail cloud. | Répartition des responsabilités entre fournisseur et client. |
Le choix doit aussi intégrer les coûts de collecte et de conservation, les connecteurs disponibles et le temps nécessaire à l’administration. Un outil puissant mal alimenté peut laisser davantage d’angles morts qu’un dispositif plus simple, correctement exploité.
L’IA et le machine learning peuvent aider à hiérarchiser les alertes ou à repérer des anomalies. Ils ne remplacent ni le contexte métier ni la validation des actions sensibles. Mieux vaut automatiser d’abord l’enrichissement d’une alerte que le blocage d’un service dont les dépendances sont mal connues.
Des responsabilités explicites avant une surveillance ambitieuse
Les analystes SOC qualifient les alertes et conduisent les premières investigations. Les spécialistes de réponse aux incidents approfondissent les compromissions complexes. Les ingénieurs de détection entretiennent les règles, tandis que les équipes IT appliquent les changements sur les systèmes. Le responsable SecOps coordonne ces fonctions avec le RSSI et les responsables métier.
Les compétences utiles associent analyse de journaux, réseaux, systèmes, identités, cloud et automatisation. La capacité à documenter une hypothèse, transmettre une investigation et expliquer un risque est tout aussi importante. Une équipe ne doit pas dépendre d’une seule personne capable de comprendre un outil ou d’autoriser une intervention.
Dans une PME, certaines fonctions peuvent être confiées à un prestataire. Une organisation plus mature peut conserver en interne la détection et déléguer une partie de la surveillance. Le choix dépend du périmètre, des compétences, du budget et des besoins de couverture. Externaliser la surveillance ne supprime pas la responsabilité de décider : les contacts, délais d’escalade et autorisations doivent rester explicites.
Déployer progressivement et mesurer la réduction du risque
Le bon point de départ consiste à inventorier les actifs critiques et à sélectionner des scénarios prioritaires : compromission d’un compte administrateur, rançongiciel ou accès anormal à des données sensibles. Pour chacun, il faut identifier les traces nécessaires, le responsable de l’analyse et les moyens de confinement disponibles.
Déployez ensuite la collecte sur ce périmètre, testez les détections et simulez les procédures de réponse. Élargir trop vite la couverture peut provoquer une accumulation d’alertes sans capacité de traitement. Les exercices révèlent souvent des obstacles concrets : journal absent, contact indisponible ou privilège insuffisant pour isoler une machine.
Pour suivre les progrès, observez notamment :
- le délai entre les premiers signes observables et la détection ;
- le temps nécessaire à la qualification et au confinement ;
- la part des alertes sans intérêt opérationnel ;
- la couverture des actifs critiques par la supervision ;
- la réapparition d’incidents liés à une cause déjà identifiée.
Ces indicateurs doivent être définis de façon stable et interprétés selon la gravité des incidents. Fermer davantage d’alertes ne signifie pas nécessairement mieux protéger l’entreprise.
Enfin, la traçabilité des investigations et des décisions soutient la conformité. SecOps contribue aux démarches ISO 27001, au cadre NIST et aux exigences PCI DSS selon le périmètre concerné, sans garantir à lui seul leur respect. Pour le RGPD, la journalisation doit aussi tenir compte des accès, de la conservation et de la protection des données personnelles. La finalité reste une sécurité démontrable, capable de détecter, agir et apprendre.